Οδηγοί & How-To
Τέσσερα μικρά αλλά ισχυρά τοπικά LLM για το PC
Αναλύουμε τέσσερα μικρά τοπικά LLM που μπορείτε να δοκιμάσετε στο PC σας, εξηγώντας ποιο ταιριάζει σε image classification, agentic coding, δημιουργική γραφή ή low‑power servers, και πώς να ρυθμίσετε quantization και cache για καλύτερη απόδοση.

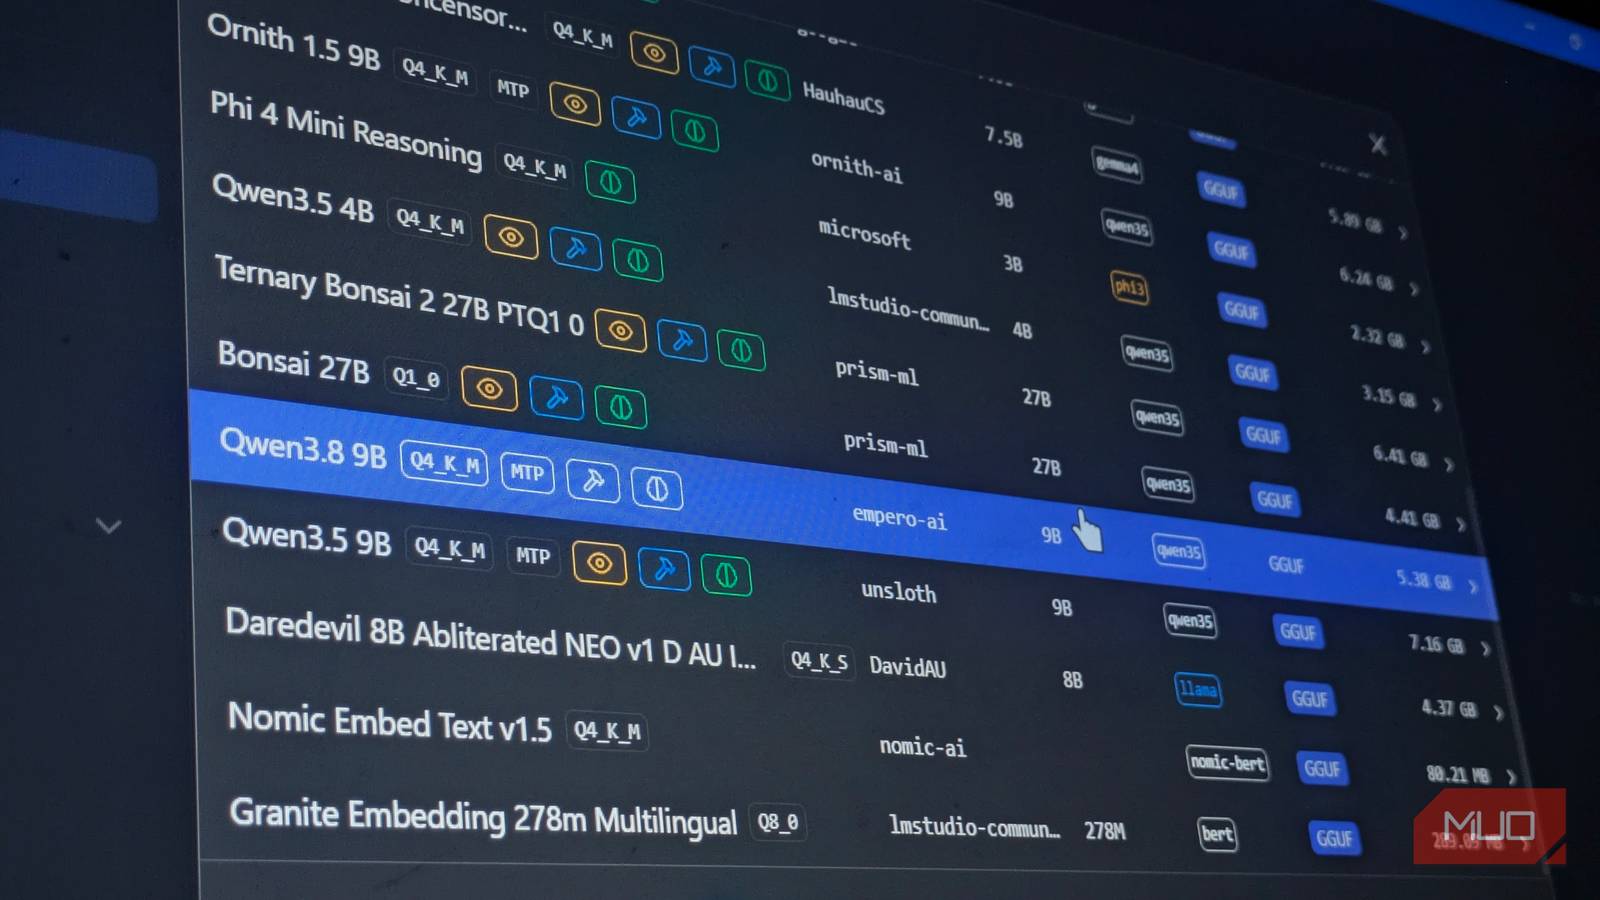
Τα τοπικά Large Language Models (LLMs) έχουν γίνει πρακτική επιλογή ακόμη και για χρήστες με περιορισμένο hardware. Με τις τεχνικές όπως distillation, quantization και προσεγμένες fine‑tunes, μοντέλα με μόλις λίγα δισεκατομμύρια παραμέτρους μπορούν να προσφέρουν καθημερινικά χρήσιμες δυνατότητες: συνοψίσεις, επεξεργασία εικόνας, agentic coding και ακόμα δημιουργική γραφή. Σε αυτό το άρθρο παρουσιάζω τέσσερα μοντέλα που δοκίμασα προσωπικά και που αξίζουν να δοκιμάσετε στο PC σας αυτό το Σαββατοκύριακο.
Γιατί τα μικρά τοπικά μοντέλα έχουν νόημα σήμερα
Η τάση προς μεγαλύτερα και πιο ακριβά μοντέλα συνεχίζεται, αλλά δεν είναι η μόνη λύση. Τα μικρότερα LLMs διαθέτουν πρακτικά πλεονεκτήματα: χαμηλότερη χρήση μνήμης, ταχύτερη εκκίνηση, μικρότερο κόστος ενέργειας και συχνά επαρκής απόδοση για συγκεκριμένες εργασίες. Επιπλέον, η δυνατότητα να τρέξετε το μοντέλο τοπικά σημαίνει πλήρη έλεγχο στα δεδομένα, μικρότερη εξάρτηση από cloud και καλύτερη ιδιωτικότητα για ευαίσθητο περιεχόμενο.
Τεχνικές όπως οι abliteration variants, οι distillations και οι aggressive quantizations επιτρέπουν να μετατρέψετε μοντέλα που αρχικά απαιτούσαν μεγάλους πόρους σε εκδόσεις που δουλεύουν σε υπολογιστές με 8 GB VRAM ή σε low‑power CPU mini‑PC. Ταυτόχρονα, οι πλατφόρμες διανομής και διαχείρισης, όπως LM Studio και Ollama, έχουν κάνει την πρόσβαση και το deployment πολύ πιο απλό — χωρίς να χρειάζεται να ψάχνετε σε διάφορα libraries.
Qwen3.8-9B-Distill: ισορροπία ανάμεσα σε γνώση και πόρους
Το Qwen3.8-9B-Distill από την Empero‑AI ήταν για μένα το πιο ισορροπημένο 9B μοντέλο για desktop χρήση. Είναι fine‑tuned έκδοση του Qwen3.5-9B, εκπαιδευμένη με outputs του πολύ μεγαλύτερου Qwen3.8-2.4T A95B. Το αποτέλεσμα δεν φτάνει την απόδοση ενός 27B, αλλά δίνει σαφή βελτίωση στην ικανότητα κατανόησης και στην ακρίβεια σε πολλαπλά tasks.
Στα benchmarks, όπως αναφέρεται και στο model card, υπάρχει μικρή πτώση στη μαθηματική επίδοση — περίπου 1.5 ποσοστιαία μονάδα στο GSM8K — αλλά σημαντική άνοδος σε general knowledge, κοντά στο +20 μονάδες στο MMLU. Επιπρόσθετα, ακολουθεί καλύτερα δομημένες οδηγίες και υποστηρίζει function calling και vision όταν κατεβάσετε το πρόσθετο mmproj αρχείο. Στην πράξη, αυτό το μοντέλο είναι πολύ βολικό για workflows που χρειάζονται ανάγνωση εγγράφων, εξαγωγή πληροφοριών και σύνδεση με τοπικά εργαλεία.
Στο προσωπικό μου εργαλείο image‑classification το μοντέλο αποδίδει καλύτερα από ένα κλασικό ONNX ML μοντέλο σε σύνθετες εικόνες, γιατί μπορεί να «σκεφτεί» πάνω σε αμφίβολες λεπτομέρειες, να επιστρέψει καλά δομημένο JSON και να επεξεργαστεί την εικόνα σε πολλαπλές διελεύσεις. Αν θέλετε ένα πιο ικανό και ενημερωμένο εναλλακτικό για το Qwen3.5-9B, το Qwen3.8‑9B‑Distill αξίζει την προσοχή σας.
Ornith-1.5-9B: ο πράκτορας προγραμματισμού που αυτοβελτιώνεται
Το Ornith-1.5-9B από τη DeepReinforce είναι σχεδιασμένο για agentic coding, δηλαδή για αυτοματοποιημένες εργασίες ανάπτυξης όπου το μοντέλο σχεδιάζει, γράφει, δοκιμάζει και βελτιώνει κώδικα. Βασίζεται στο Qwen‑3.5‑9B και βελτιώνει την προηγούμενη έκδοση Ornith‑1.0‑9B με ένα ενσωματωμένο RL loop αυτοβελτίωσης.
Αυτή η διαδικασία λειτουργεί σαν ένα προ-συσκευασμένο harness: το μοντέλο διατυπώνει πλάνο, δημιουργεί τεστ, αξιολογεί τα αποτελέσματα και επαναλαμβάνει τη βελτίωση. Στην πράξη σημαίνει ότι για μικρά έως μεσαίου μεγέθους project μπορεί να παραδώσει πλήρως λειτουργικές landing pages ή CLI εργαλεία σε έναν κύκλο, χωρίς διαρκή ανθρώπινη επιτήρηση. Το κόστος είναι μεγαλύτερη χρήση tokens και context, άρα περιορίζεται η κλίμακα των projects σε σχέση με έναν πλήρη ανθρώπινο developer.
Χρησιμοποιώντας το σε σύζευξη με OpenCode ως εξωτερικό development harness είδα καλά αποτελέσματα: γρήγορο iteration, αυτόματες διορθώσεις και αξιόπιστες δοκιμές. Αν ο κύριος στόχος σας είναι η παραγωγή κώδικα τοπικά, το Ornith‑1.5‑9B είναι από τα καλύτερα 9B μοντέλα που δοκίμασα και αξίζει μια δοκιμή, ειδικά όταν δεν μπορείτε να τρέξετε μοντέλα 35B ή μεγαλύτερα.
Qwythos-9B-v2: δημιουργική γραφή χωρίς λογοκρισία
Το Qwythos-9B-v2 της Empero AI δεν φέρει την ετικέτα «uncensored» στο όνομα, αλλά είναι σχεδιασμένο με λιγότερους περιορισμούς. Βασίζεται στο Qwen3.5-9B και στοχεύει στη μείωση του looping και της επανάληψης, δύο κοινούς πονοκεφάλους σε δημιουργικά σενάρια. Από τα μικρότερα uncensored μοντέλα που δοκίμασα — όπως DareDevil‑8B και Gemma‑4‑E4B — το Qwythos‑9B‑v2 ξεχώρισε για πιο ζωντανές σκηνές δράσης και καλύτερες διαπροσωπικές αλληλεπιδράσεις χαρακτήρων.
Είναι ένα από τα πιο αργά μοντέλα στην ομάδα, αλλά με σωστές ρυθμίσεις γίνεται αποδοτικό: στις δοκιμές μου κατάφερα περίπου 30 tokens/s με context window κοντά στα 68K tokens. Χρειάστηκε να μειώσω την precision του KV cache σε Q5_1 για να χωρέσει στη μνήμη, χωρίς όμως εμφανή πτώση στην ποιότητα της γραφής. Για συγγραφείς, game designers και role‑players που θέλουν λιγότερους περιορισμούς στον δημιουργικό διάλογο, το Qwythos προσφέρει μια καλή ισορροπία μεταξύ ελευθερίας και συνοχής.
Llama-3.2-3B-Instruct: αξιόπιστο για low‑power συστήματα
Το Llama‑3.2‑3B‑Instruct είναι το μοντέλο που προτείνω για παλαιότερα PC ή CPU‑only mini‑PC που χρειάζονται πάντα‑αναμμένο τοπικό assistant. Με περίπου 3.21 δισεκατομμύρια παραμέτρους προσφέρει ταχεία εκκίνηση, χαμηλή κατανάλωση μνήμης και αξιοπρεπείς ικανότητες σε διάλογο, περίληψη και εκτέλεση οδηγιών. Δεν θα αντικαταστήσει ένα 9B σε πολύπλοκο reasoning, όμως για RAG workflows και τοπικές βάσεις γνώσης είναι ιδανικό.
Στη δική μου χρήση, το τρέχω σε home server με Project NOMAD για αναζητήσεις στο τοπικό αποθετήριο Kiwix και σε αρχεία forum που έχω κατεβάσει. Το μοντέλο συνοψίζει τα αποτελέσματα καθαρά και δίνει χρηστικές απαντήσεις. Η εμπειρία μου δείχνει ότι γύρω στα 3B είναι το όριο όπου τα instruct μοντέλα αρχίζουν να χάνουν συνοχή και να εμφανίζουν hallucinatory συμπεριφορές όταν τα σπρώχνεις υπερβολικά, αλλά για βασικές ανάγκες είναι ένα σταθερό και οικονομικό εργαλείο.
Πρακτικές ρυθμίσεις για να τρέξουν καλά τα μοντέλα στο σύστημά σας
Ο καλύτερος τοπικός LLM δεν είναι πάντα ο μεγαλύτερος. Συχνά το θέμα είναι ποιο build ταιριάζει στο hardware σας και ποιο fine‑tuning έχετε κάνει στις ρυθμίσεις. Μερικές βασικές πρακτικές συμβουλές πριν ξεκινήσετε: προτιμήστε builds τύπου Q4_K_M όπου είναι διαθέσιμα, γιατί δίνουν καλό ισοζύγιο ταχύτητας και χρήσης μνήμης. Αν χρειάζεστε περισσότερο context αλλά έχετε περιορισμένη VRAM, δοκιμάστε Q8_0 για το K και V cache ώστε να μειώσετε τη συνολική χρήση μνήμης.
Όπου ο runtime και το μοντέλο υποστηρίζουν MTP decoding, δοκιμάστε με 3 draft tokens και συγκρίνετε ταχύτητες με το MTP απενεργοποιημένο. Μερικές βελτιώσεις προέρχονται από δοκιμές και όχι από θεωρία — ξεκινήστε με ένα μοντέλο, δείτε πώς συμπεριφέρεται στο σύστημά σας και αλλάξτε ρυθμίσεις σταδιακά. Επίσης να θυμάστε ότι αλλαγές όπως η precision του KV cache (π.χ. Q5_1) μπορούν να απελευθερώσουν αρκετή μνήμη χωρίς εμφανή ρύπανση στην ποιότητα για πολλές εργασίες.
Τέλος, η πλατφόρμα που θα επιλέξετε για deployment παίζει ρόλο: LM Studio και Ollama προσφέρουν εύκολη εγκατάσταση και διαχείριση μοντέλων, αλλά οι ρυθμίσεις runtime και οι παραμέτρους quantization διαφέρουν. Μην διστάσετε να δοκιμάσετε εναλλακτικά runtimes αν ένα μοντέλο δεν αποδίδει όπως περιμένατε — σε διαφορετικές μηχανές τα ίδια builds μπορεί να συμπεριφέρονται πολύ διαφορετικά.
Γιατί έχει σημασία και τι αλλάζει στην πράξη
Η διάδοση μικρών, αποδοτικών τοπικών LLM αλλάζει το πώς πολλοί χρήστες θα αλληλεπιδρούν με την AI καθημερινά. Αντί για μονοπώλιο cloud υπηρεσιών, κερδίζουν χώρο τοπικά, εξατομικευμένα workflows που σέβονται την ιδιωτικότητα και τη διάρκεια ζωής της συσκευής. Από τοπικά εργαλεία ταξινόμησης εικόνων έως αυτόματους βοηθούς ανάπτυξης κώδικα και δημιουργικές εφαρμογές, οι δυνατότητες γίνονται προσβάσιμες σε περισσότερους χρήστες με περιορισμένους πόρους.
Στην πράξη, αυτό σημαίνει ότι μπορείτε να έχετε έναν αξιόπιστο assistant στο παλιό σας mini‑PC, έναν δημιουργικό συνεργάτη για σεναριακή γραφή στο laptop ή έναν agent που φτιάχνει μικρές εφαρμογές χωρίς να χρειάζεται σύνδεση στο cloud. Αν ξεκινήσετε με ένα από τα τέσσερα μοντέλα που προτείνω, θα πάρετε μια καλή εικόνα του τι είναι εφικτό σήμερα και θα μάθετε γρήγορα πώς να προσαρμόζετε ρυθμίσεις ώστε να αξιοποιήσετε στο έπακρο το hardware που έχετε.